Döngülü Transformer'lar ya da Tekrarlayan Derinlik Modelleri
Yayınlanma tarihi 2026-10-176 dk okuma1,182 kelime7 gün içinde güncellendiLisans CC BY-NC-SA 4.0artificial intelligencecomputer scienceai safetyllmsscalingmachine learningwritingpersonalİçindekiler
Giriş
X'te @scaling01 sayesinde, gözden kaçmış ama son aylarda laboratuvarların da el attığı eğitim/ölçekleme paradigmasının yeni bir boyutu haline gelmiş bir kavramla tanıştım. Bazı kavramları açıklarken birçok makaleye ve en çok da Q Labs'in yazısına dayanacağım; çünkü bence bu alandaki en net ve en etkili çalışma o. Üstelik oldukça yakın zamanda çıktı ve anlaşılması kolay.
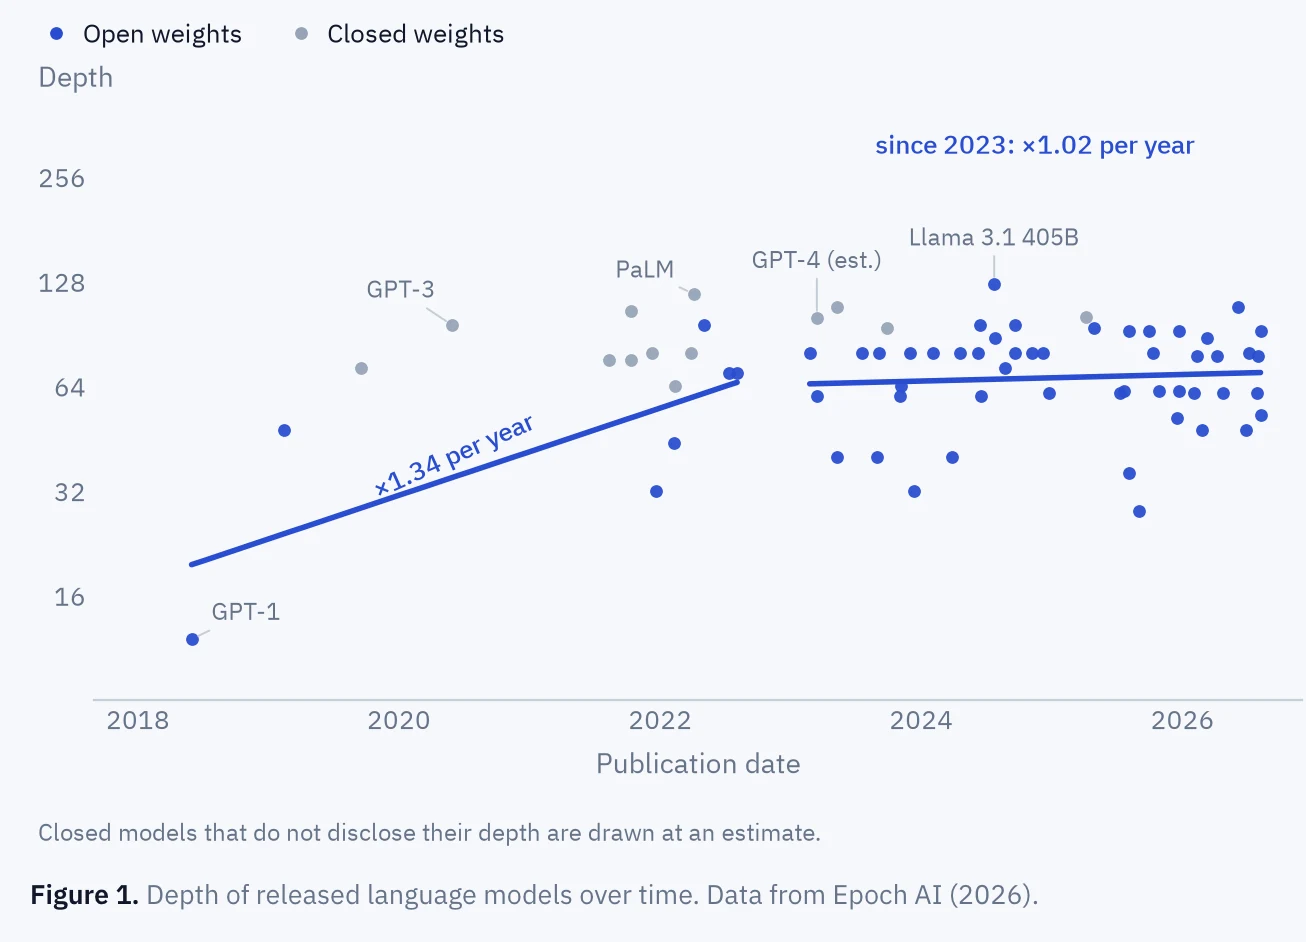
GPT-3'ten bu yana eğitimde ölçeklemenin birçok boyutunu gördük: parametre sayısı, pre-training veri boyutu, mixture of experts ile seyreklik (sparsity), test-time compute'un uzatılması vb. Derinlik ise şimdiye kadar ölçeklemenin göz ardı edilen bir alanıydı. Mevcut frontier modellerin çoğu aşağı yukarı 100 katman civarında ve bu uzun zamandır değişmiyordu. Şimdi değişiyor.
Döngülü transformer nedir?
Standart bir transformer'da N katman vardır ve her token her katmandan bir kez geçer. Döngülü bir model ise bazı katmanları saklar ve bir token üretmeden önce hidden state'leri bu bloklardan birkaç kez geçirir.
Bunu neden yapalım ki?
- Parametre verimliliği: Modelin ağırlıkları döngüler arasında paylaşılır; böylece efektif hesaplama artar ama saklanan parametre sayısı artmaz.
- Latent uzayda akıl yürütme: Bir katmandan yapılan her ekstra geçiş, gizli uzayda bir düşünme adımıdır; bu latent uzayda gerçekleştiği için hiçbir token üretilmez, ama ekstra düşünmenin faydalarını yine de elde edersiniz.
- Adaptif hesaplama (adaptive compute): Zor problemler doğru cevaba ulaşmak için daha fazla döner, kolay problemler ise daha az döngüye ihtiyaç duyar; böylece her problem için optimum miktarda hesaplama harcayabilirsiniz. Bu, her geçişin çıktısını olasılıksal olarak puanlayıp döngüyü durdurmaya ya da sürdürmeye karar vererek yapılır.
Bu mimaride bellekten ve parametreden tasarruf edersiniz, ama hesaplama ve latency eklenen her döngüyle birlikte yine de artar.
Bu fikir nereden geliyor?
Döngülü Transformer fikri ilk olarak 2019'da ICLR'de (International Conference on Learning Representations) "Universal Transformers" adıyla yayımlandı. Çalışma, Amsterdam Üniversitesi'nden Mostafa Dehghani ile Google DeepMind ve Google Brain araştırmacılarının ortak ürünüydü.
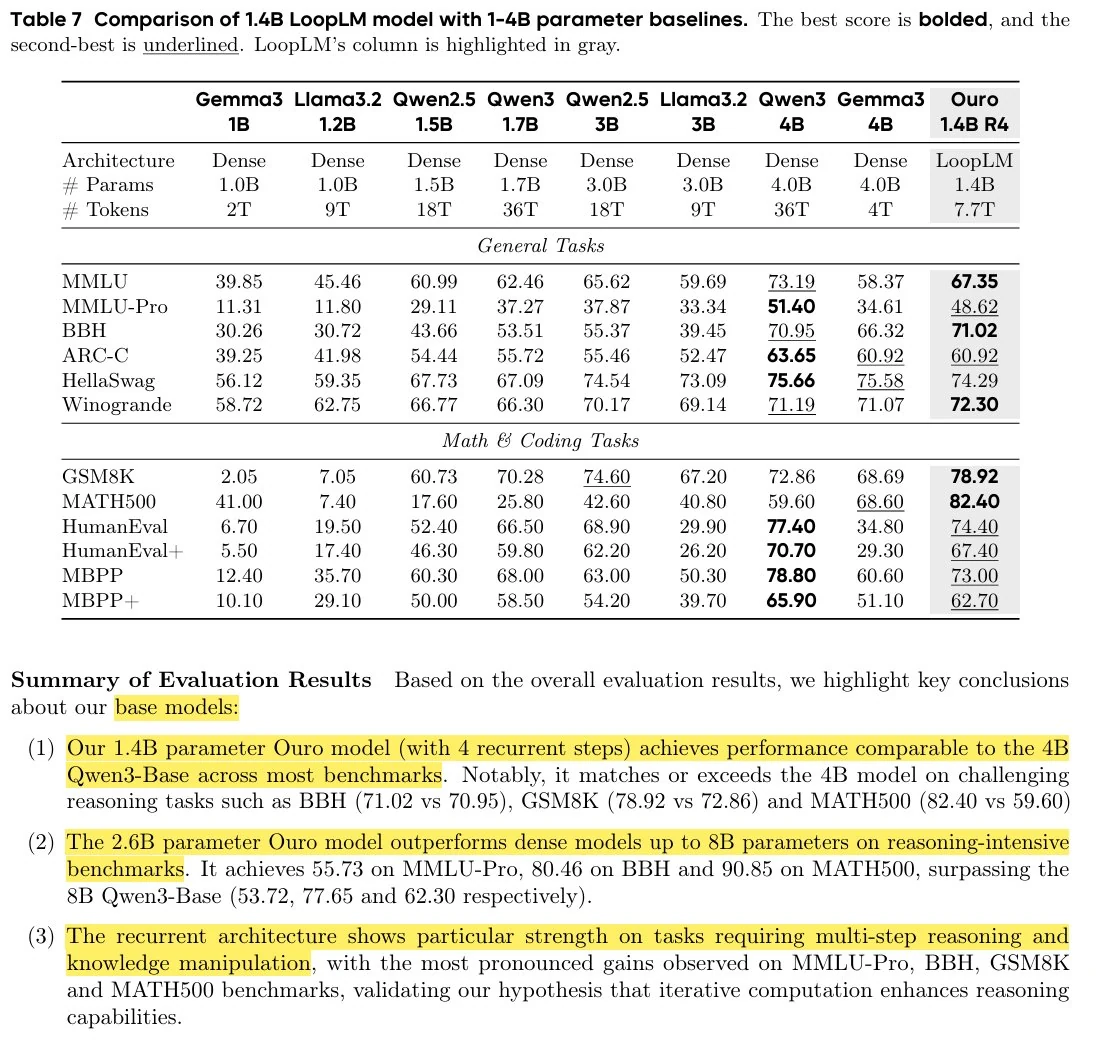
Huginn (Geiping vd.), 2025'in başında 800B token üzerinde 3.5B'lik döngülü bir model eğiten ilk çalışmaydı; ama (bildiğim kadarıyla) bu tarifi döngülü dil modelleri için çok daha büyük bir ölçeğe ilk taşıyan, adını Ouroboros'tan alan (güzel bir döngü göndermesi) Ouro 1.4B ve 2.6B modelleriyle ByteDance oldu. Bu, 7.7T token üzerinde eğitilmiş ve tüm katman yığınını döngüye sokan bir modeldi. Ayrıca, yukarıda anlattığım gibi, sabit bir döngü sayısı kullanmak yerine döngüden ne zaman çıkılacağına karar veren öğrenilmiş bir çıkış mekanizması da ekledi. 1.4B model 24 katmanlı, decoder-only bir Transformer'dı; 2.6B model ise 48 katmanlıydı. Kendi benchmark'larında 1.4B model 4B parametreli modellerle, 2.6B model ise 8B ile 12B parametreli modellerle aynı seviyedeydi.
Döngü neden son zamanlarda gündemde?
Eylül ayında The Information, OpenAI'ın yeni modeli Astra'nın bir tekrarlayan derinlik (recurrent depth) modeli olduğunu bildirdi. Bu, frontier model ölçeklerinde bile derinliğe odaklanmanın ve döngülü transformer tarifinin emergent yetenekleri açığa çıkarabileceği, dolayısıyla ciddiye alınması gerektiği anlamına geliyordu.
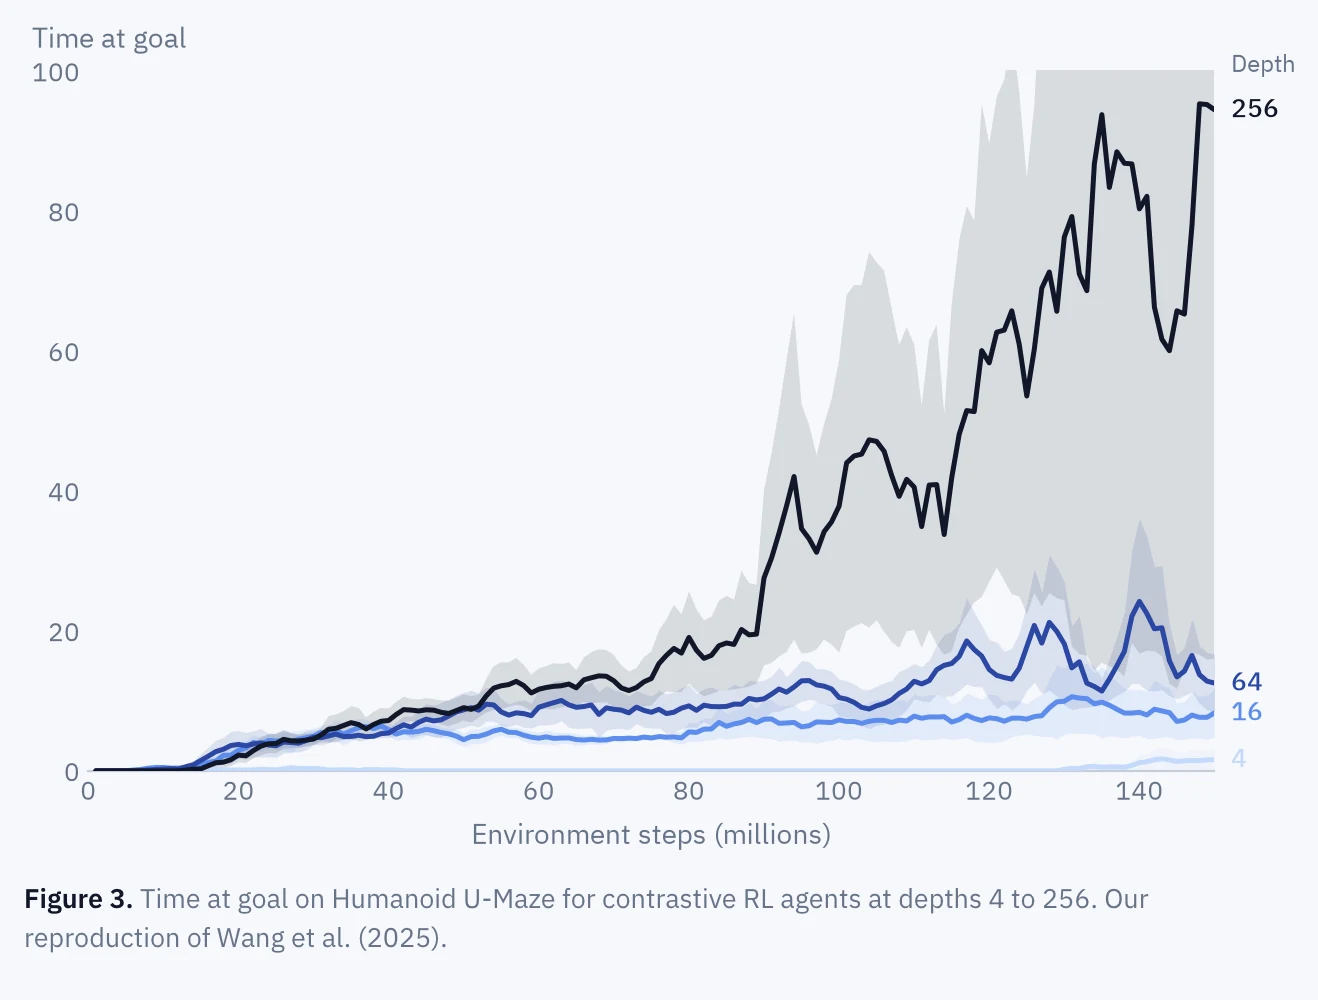
O dönemde yaygın kanı, pekiştirmeli öğrenme (reinforcement learning) ajanlarının sığ bir mimariyle (2–5 katman) en iyi sonucu verdiği yönündeydi; ancak Wang vd. (2025), "1000 Layer Networks for Self-Supervised RL" makalesinde durumun böyle olmadığını ve yeteneklerin 1024 katmana kadar artmaya devam ettiğini gösterdi. Teorik olarak, RL ajanlarını hafife alıyorduysak belki eğitim aşamasında tekrarlayan derinliği de hafife alıyorduk?
Hangi laboratuvarlar döngülü modeller kullanıyor?
Hiçbir laboratuvar bunu resmi olarak doğrulamamış olsa da Astra'nın ve daha yakın zamanda Gemini 4 Argon'un tekrarlayan derinlik modelleri olduğundan şüpheleniliyor.
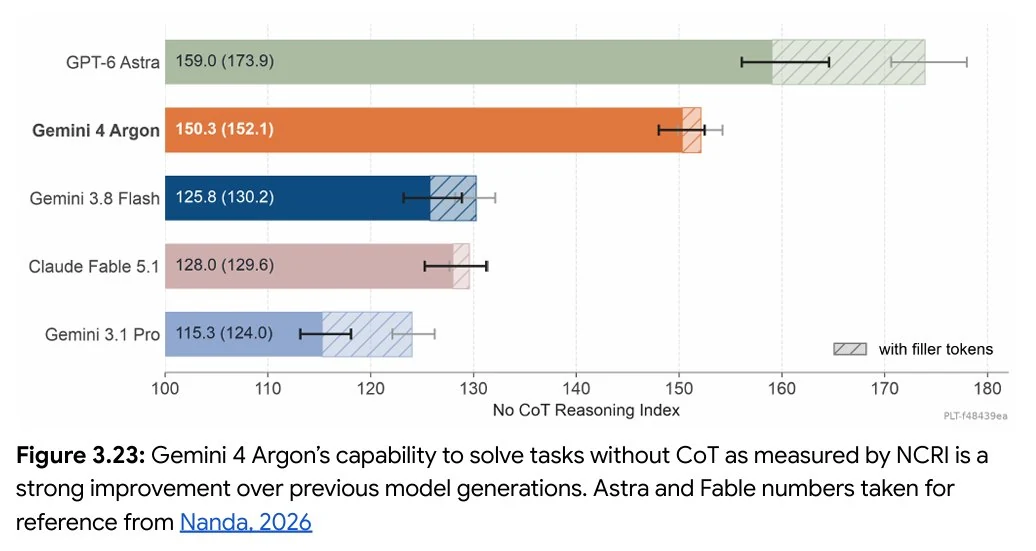
Yukarıdaki grafik biraz açıklama gerektiriyor; aynı zamanda döngülü transformer'lardaki güvenlik ve izlenebilirlik (monitorability) tartışmasına da güzel bir geçiş sağlıyor.
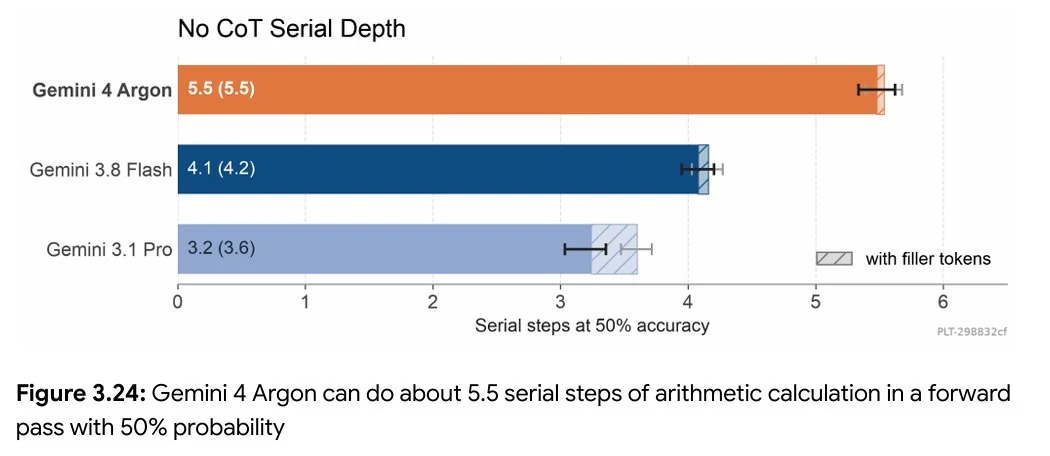
Şu anda test-time compute ve düşünce zinciri (chain of thought, CoT) ile akıl yürütme, bir modelin görevleri çözmede daha iyi hale gelmesinin başlıca yolları. Dolayısıyla bir modelin No CoT Reasoning Index'teki skoru bu kadar sert bir şekilde sıçradığında, mimaride bir değişiklik olmuş olması oldukça olası; bu da hem Astra'da hem de Gemini 4 Argon'da tekrarlayan derinlik kullanıldığına işaret ediyor.
Asıl kanıt (smoking gun) aşağıdaki grafik: sabit derinlikli transformer'lar katman sayılarıyla sınırlıdır; CoT olmadan belirgin şekilde daha yüksek bir seri derinliğe (serial depth) ulaşmak, modelin hesaplamayı yeniden kullandığını gösterir (residual stream güncellemelerini döngüye sokmak ya da buna denk bir tekrarlayan mekanizma).
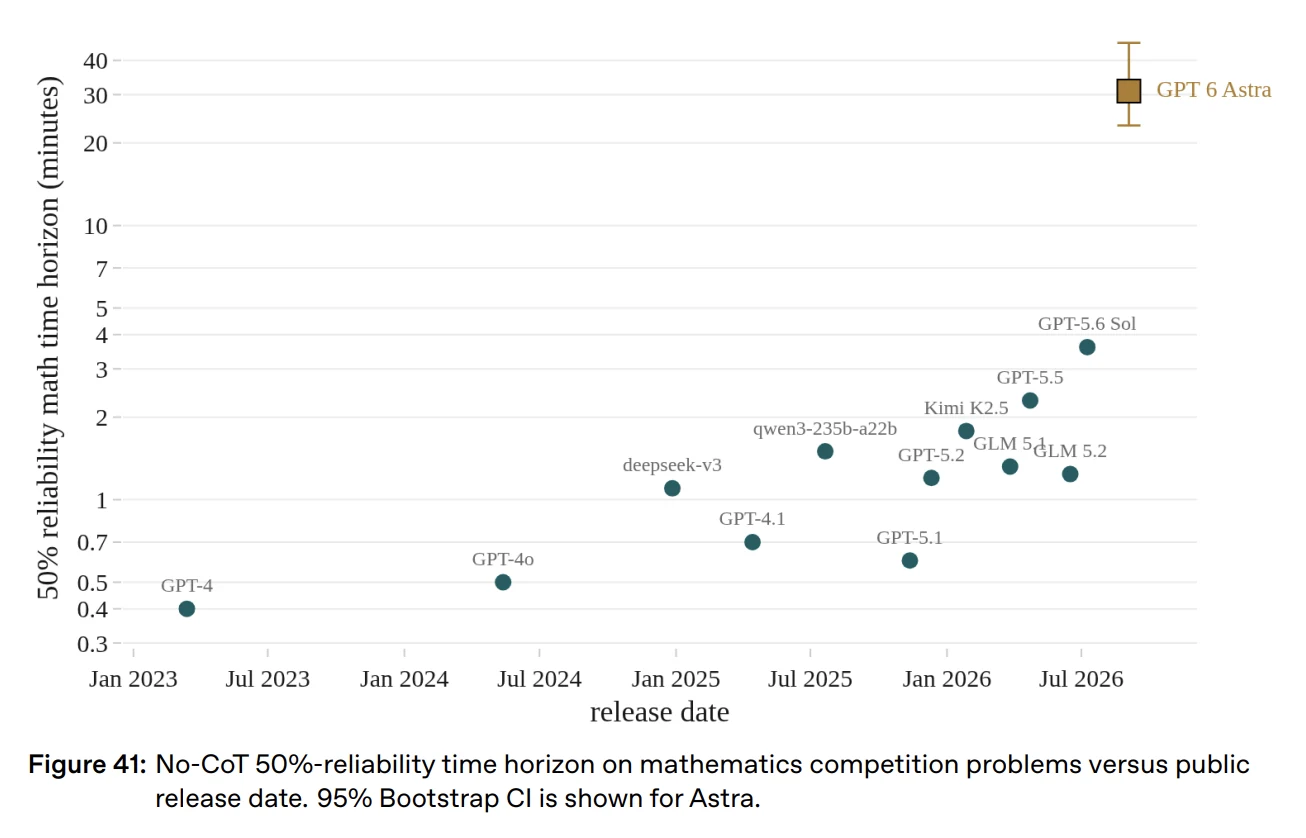
Astra'ya gelince, system card'ının 73. sayfasında (bölüm 9.3) UK AISI, Astra'nın önceki modellere kıyasla "tek bir forward pass'te belirgin şekilde daha zor matematik problemlerini çözebildiğini" tespit etti. Astra'nın time horizon'u, GPT-5.6 Sol'un 3,6 dakikasına kıyasla 30,9 dakikaydı.
Bu, tek bir nesilde 8,6 katlık bir sıçrama demek! Ryan Greenblatt (METR'de MTS), CoT'siz time horizon'ların kabaca her 9 ayda bir ikiye katlandığını ölçmüştü. Bu da yaklaşık üç kez ikiye katlanma, yani iki yılı aşkın bir ilerlemenin tek bir nesle sıkıştırılması demek (gerçi UK AISI'nin kurulumu onunkinden farklı olabilir).
UK AISI, Fable 5 ve Mythos 5 üzerinde de benzer değerlendirmeler yaptı, ancak CoT'siz akıl yürütme yeteneğinde bu tür bir sıçrama raporlamadı. Neel Nanda'nın Fable 5.1 için kendi ölçtüğü No CoT Reasoning Index skorları da döngüsüz transformer modellerininkine benzerdi; bu da Anthropic'in henüz modellerine tekrarlayan derinlik eklemediğine işaret ediyor. Ancak bu gelecekte değişebilir. (Gözümüz sende, Fable 5.5.)
Döngülü transformer'larda CoT'siz akıl yürütmenin gelişmesinin nedeni şu: tek bir forward pass'teki akıl yürütme, modelin sahip olduğu ardışık adım sayısıyla sınırlıdır ve döngü, daha fazla adım eklemenin ucuz bir yoludur. 64 katmanlı bir model token başına 64 ardışık adım atar, ardından cevabını verir. CoT bu sınırı aşmak için akıllıca bir çözüm. Model en son hesapladığı token'ı üretir, sonra CoT üzerinden mimarinin dışında döngüye devam eder ve problemi çözene kadar onun üzerinde tekrar tekrar akıl yürütür. Tekrarlayan derinlik modeli ise bu döngü işini kendi ağının içinde yapar; yani problemi çözmek için içsel CoT'sini yazıya dökmesine gerek kalmaz. Ancak bu da beraberinde kendi zorluklarını getirir.
Güvenlik Tartışması
Şu anda CoT izleme (CoT monitoring), modelin bilişine göz atmak için elimizdeki en güvenilir yol. CoT'de bir uyarı işareti belirirse modeli durdurabilir ve planladığı, potansiyel olarak zararlı eylemi engelleyebiliriz.
Buna karşılık döngülü transformer, "akıl yürütmesinin" daha büyük bir kısmını latent uzayda yapabilir. Fark şu: akıl yürütmenin daha fazlası, hiç token üretilmeyen döngülerin içinde gerçekleşebilir; dolayısıyla izleyebilmemiz için CoT'ye yansıyan kısmı azalır. İçeride bir uyarı işareti olsaydı fark edilmeden geçip gidebilirdi. Yani döngülü transformer'lar kullandığımızda yapay zeka modellerinin izlenebilirliğinden bir miktar kaybediyoruz. Astra'nın tekrarlayan derinlik kullandığı bildirildiğinde ilk kaşları kaldıran güvenlik sorunu buydu; Anthropic'in kendi modellerine henüz tekrarlayan derinlik eklememesinin nedeni de muhtemelen bu.
Sonuç
Döngülü transformer, ya da tekrarlayan derinlik modeli, laboratuvarlar yeni modellerinde kullanmaya başladıkça çok daha fazla ilgi göreceği kesin olan yeni bir ölçekleme paradigması. İzlenebilirlik sorunu bir şekilde çözülürse (ya da çözüldüğünde), getirdiği zeka ve akıl yürütme ilerlemeleri sayesinde onu tercih etmemek için hiçbir neden kalmayacak. Hangi katmanların döngüye sokulması gerektiğini, hangilerinin gerekmediğini belirlemek de zor. Bu da, her zaman olduğu gibi, yapay zeka modeli eğitmeye bir sanat katmanı daha ekliyor. Ne kadar compute olursa olsun, zevkin yerini tutamaz. (Selam, Google!)